제목: LingBot-VA 2.0: 범용 로봇 제어를 위해 처음부터 설계된 차세대 비디오 액션 모델
질문: LingBot-VA 2.0은 기존 로봇 파운데이션 모델과 무엇이 다르며, 왜 주목받고 있을까요?
답변: LingBot-VA 2.0은 기존의 비디오 생성 모델을 로봇 제어에 응용하는 방식이 아니라, 처음부터 로봇의 물리적 움직임과 제어를 위해 설계된 비디오 액션(Video Action) 기반 파운데이션 모델입니다. 시각 정보와 로봇 동작을 하나의 표현 공간으로 통합하고, 혼합 전문가(MoE) 구조와 미래 행동 예측(Foresight Reasoning)을 적용해 더욱 빠르고 정확한 실시간 제어를 구현한 것이 가장 큰 특징입니다.
요약: 기존의 많은 로봇 AI 모델은 범용 비디오 생성 모델을 기반으로 개발되면서 실제 로봇 제어에서는 추론 속도가 느리고, 영상과 로봇 동작 사이의 불일치 문제가 존재했습니다. LingBot-VA 2.0은 이러한 한계를 해결하기 위해 처음부터 로봇 제어를 목적으로 설계되었습니다. 특히 시맨틱 비주얼 액션 토크나이저(Semantic Visual Action Tokenizer)를 통해 영상 정보와 로봇의 행동을 긴밀하게 연결하고, 혼합 전문가(MoE, Mixture of Experts) 구조를 적용해 연산 효율을 높이면서도 실시간 제어 성능을 크게 향상시켰습니다.
또한 다중 청크 예측(MCP, Multi-Chunk Prediction) 기술을 도입해 현재 동작만 보는 것이 아니라 앞으로 이어질 여러 단계의 움직임까지 함께 학습합니다. 이를 통해 기존 로봇이 자주 보였던 근시안적인 제어 문제를 줄이고 보다 자연스럽고 안정적인 작업 수행이 가능해졌습니다. 여기에 **비디오 인 컨텍스트 학습(ICL, In-Context Learning)**을 적용하여 적은 수의 시연만으로도 새로운 작업을 빠르게 습득할 수 있으며, 다양한 작업 환경에서도 높은 일반화 성능을 보여줍니다.
가장 주목할 부분은 포어사이트 리즈닝(Foresight Reasoning)입니다. 로봇이 현재 상태만 판단하는 것이 아니라 다음 행동을 미리 예측하며 움직이기 때문에 더욱 부드럽고 자연스러운 제어가 가능합니다. 이를 기반으로 최대 225Hz의 비동기 실행 주파수를 구현하여 기존 모델보다 훨씬 빠른 실시간 반응 속도를 제공합니다. 결과적으로 LingBot-VA 2.0은 장기 작업 계획(Long Horizon Planning)부터 정밀한 조작까지 모두 수행할 수 있는 차세대 범용 로봇 파운데이션 모델로 평가받고 있습니다.


제목: LingBot-VA 2.0: 범용 로봇 제어를 위해 처음부터 설계된 차세대 비디오 액션 모델
질문: LingBot-VA 2.0은 기존 로봇 파운데이션 모델과 무엇이 다르며, 왜 주목받고 있을까요?
답변: LingBot-VA 2.0은 기존의 비디오 생성 모델을 로봇 제어에 응용하는 방식이 아니라, 처음부터 로봇의 물리적 움직임과 제어를 위해 설계된 비디오 액션(Video Action) 기반 파운데이션 모델입니다. 시각 정보와 로봇 동작을 하나의 표현 공간으로 통합하고, 혼합 전문가(MoE) 구조와 미래 행동 예측(Foresight Reasoning)을 적용해 더욱 빠르고 정확한 실시간 제어를 구현한 것이 가장 큰 특징입니다.
요약: 기존의 많은 로봇 AI 모델은 범용 비디오 생성 모델을 기반으로 개발되면서 실제 로봇 제어에서는 추론 속도가 느리고, 영상과 로봇 동작 사이의 불일치 문제가 존재했습니다. LingBot-VA 2.0은 이러한 한계를 해결하기 위해 처음부터 로봇 제어를 목적으로 설계되었습니다. 특히 시맨틱 비주얼 액션 토크나이저(Semantic Visual Action Tokenizer)를 통해 영상 정보와 로봇의 행동을 긴밀하게 연결하고, 혼합 전문가(MoE, Mixture of Experts) 구조를 적용해 연산 효율을 높이면서도 실시간 제어 성능을 크게 향상시켰습니다.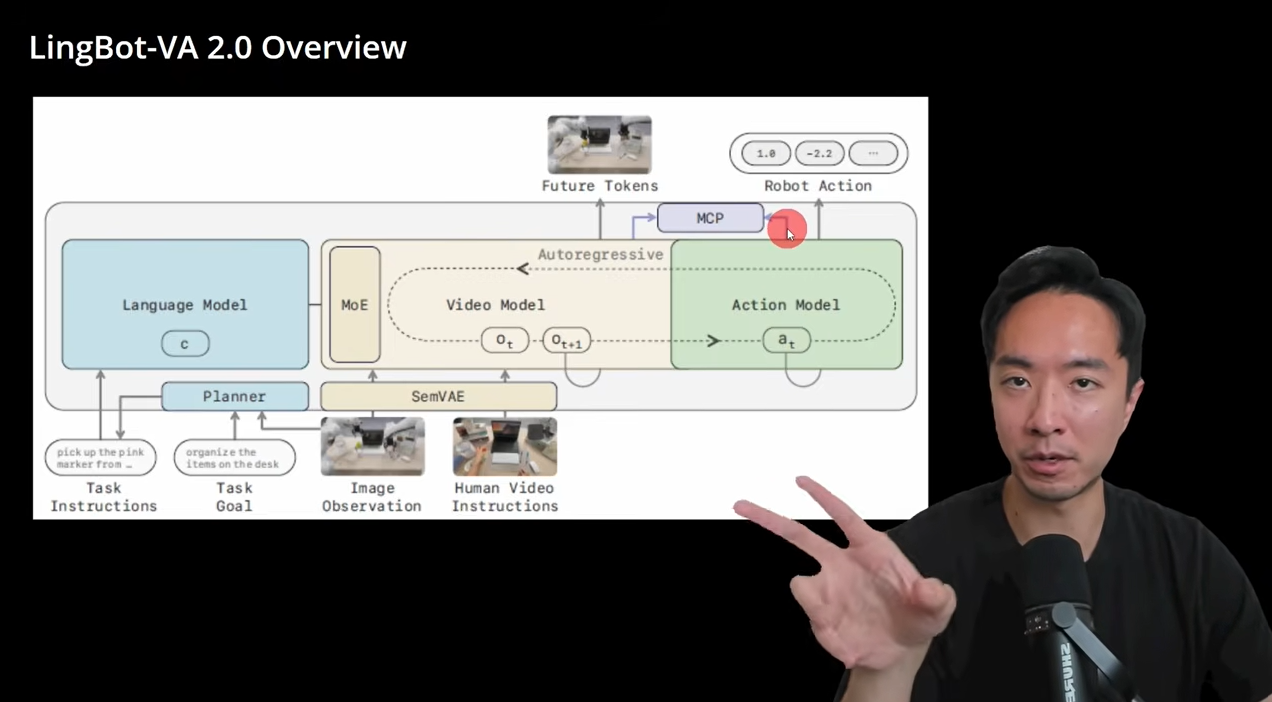
또한 다중 청크 예측(MCP, Multi-Chunk Prediction) 기술을 도입해 현재 동작만 보는 것이 아니라 앞으로 이어질 여러 단계의 움직임까지 함께 학습합니다. 이를 통해 기존 로봇이 자주 보였던 근시안적인 제어 문제를 줄이고 보다 자연스럽고 안정적인 작업 수행이 가능해졌습니다. 여기에 **비디오 인 컨텍스트 학습(ICL, In-Context Learning)**을 적용하여 적은 수의 시연만으로도 새로운 작업을 빠르게 습득할 수 있으며, 다양한 작업 환경에서도 높은 일반화 성능을 보여줍니다.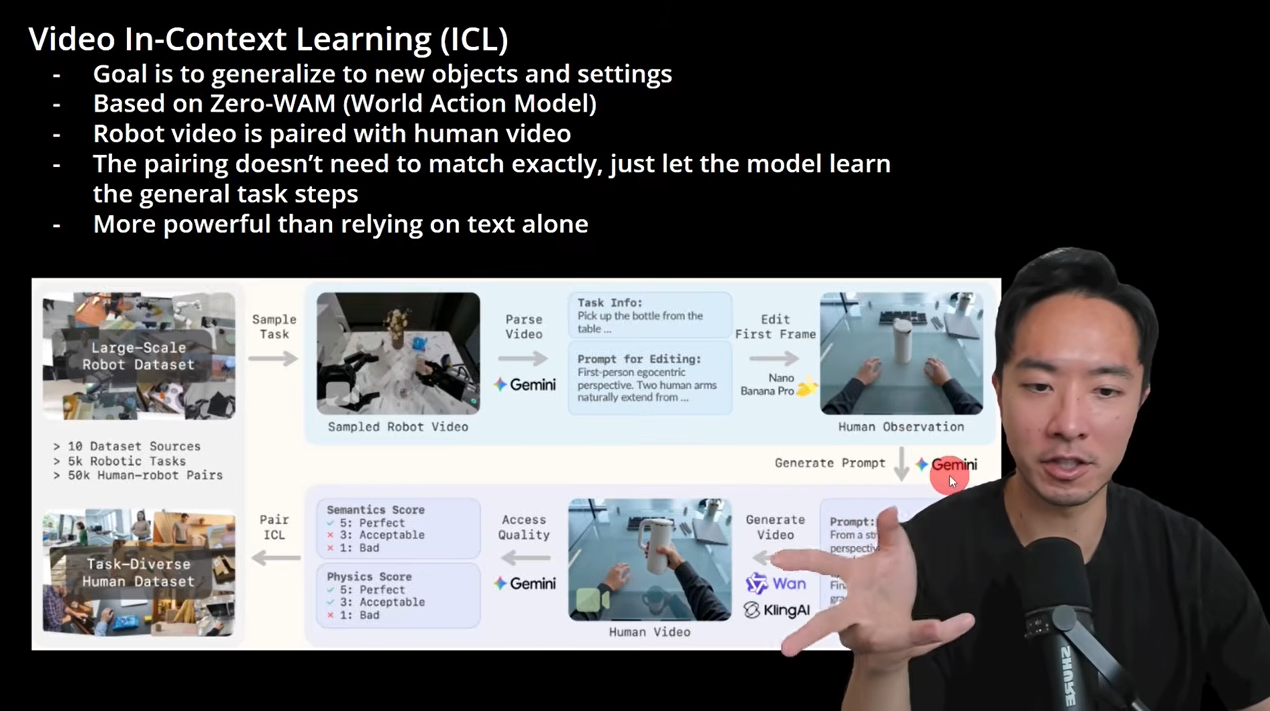
가장 주목할 부분은 포어사이트 리즈닝(Foresight Reasoning)입니다. 로봇이 현재 상태만 판단하는 것이 아니라 다음 행동을 미리 예측하며 움직이기 때문에 더욱 부드럽고 자연스러운 제어가 가능합니다. 이를 기반으로 최대 225Hz의 비동기 실행 주파수를 구현하여 기존 모델보다 훨씬 빠른 실시간 반응 속도를 제공합니다. 결과적으로 LingBot-VA 2.0은 장기 작업 계획(Long Horizon Planning)부터 정밀한 조작까지 모두 수행할 수 있는 차세대 범용 로봇 파운데이션 모델로 평가받고 있습니다.
#LingBotVA #로봇AI #VLA #피지컬AI #로보타운