[VLA]VLA가 물리 세계를 배우는 방법 | 시연 데이터·월드 파운데이션 모델·디지털 트윈 최신 논문 총정리
2026-07-31
조회수 154
제목: VLA가 물리 세계를 배우는 방법 | 시연 데이터·월드 파운데이션 모델·디지털 트윈 최신 논문 총정리
질문: 시각·언어·행동 모델은 어떻게 접촉력과 촉각을 배우고, 행동 결과까지 미리 예측할 수 있을까요?
답변: 로봇이 실제 환경에서 물체를 안정적으로 다루려면 카메라 영상과 언어 명령만으로는 부족합니다. 사람의 시연에서 접촉력과 촉각 같은 물리 정보를 수집해 학습하고, 행동하기 전에 월드 파운데이션 모델과 디지털 트윈으로 미래 결과를 예측해야 합니다. 이를 통해 로봇은 물리 세계를 단순히 보는 수준을 넘어 이해하고 판단할 수 있습니다.
이번 2편에서는 그 다음 흐름으로, 로봇이 물리 세계를 어떻게 배우고 예측할 수 있는지 살펴보려고 합니다.
먼저 Feel the Force와 OSMO를 통해 사람의 시연 데이에서 접촉력과 촉각 같은
물리량을 함께 수집하려는 연구들을 정리하고,
이어서 Cosmos WFM, Prompting with the Future, PhysWorld를 통해
World Foundation Model과 Digital Twin이
로봇의 행동 결과를 어떻게 미리 예측하려는지 파헤쳐보았습니다.
결국 Physical AI가 실제 세계에서 더 안정적으로 작동하려면,
로봇은 눈으로 보는 것을 넘어 물체와의 접촉, 힘의 변화, 그리고
행동 이후의 미래까지 함께 이해할 수 있어야 합니다.
이번 영상에서는 이러한 흐름이 최신 연구들에서 어떻게 나타나고 있는지 살펴보았습니다.
00:00 인트로
00:34 시연 데이에서 물리량을 함께 수집한다 | Feel the Force·OSMO
06:40 WFM/Digital Twin으로 물리 미래를 예측한다 | Cosmos·Prompting with the Future·PhysWorld
25:25 아웃트로
요약: 시각·언어·행동 모델은 사람의 명령과 카메라 영상을 바탕으로 로봇의 행동을 생성하지만, 실제 물체를 다루는 작업에서는 힘을 얼마나 주어야 하는지가 매우 중요합니다. ‘필 더 포스’와 ‘오스모’ 연구는 사람의 시연 데이터에서 영상뿐 아니라 접촉력과 촉각 같은 물리량을 수집하고 로봇 학습에 활용하는 방법을 제시합니다. 컵을 잡거나 서랍을 열고, 부드러운 물체를 다룰 때 필요한 정밀한 힘 조절 능력을 인간의 행동으로부터 전달하려는 것입니다.
후반부에서 소개되는 코스모스, 미래를 활용한 프롬프팅, 피즈월드 연구는 로봇이 행동하기 전에 그 결과를 예측하는 기술에 초점을 맞춥니다. 월드 파운데이션 모델과 디지털 트윈을 이용하면 로봇이 물체를 밀거나 잡았을 때 어떤 변화가 일어날지를 가상 환경에서 먼저 확인할 수 있습니다. 앞으로의 로봇은 보이는 장면에 즉시 반응하는 수준을 넘어, 접촉과 힘을 이해하고 여러 행동의 미래 결과를 비교한 뒤 가장 안전하고 성공 가능성이 높은 행동을 선택하는 방향으로 발전할 전망입니다.


제목: VLA가 물리 세계를 배우는 방법 | 시연 데이터·월드 파운데이션 모델·디지털 트윈 최신 논문 총정리
질문: 시각·언어·행동 모델은 어떻게 접촉력과 촉각을 배우고, 행동 결과까지 미리 예측할 수 있을까요?
답변: 로봇이 실제 환경에서 물체를 안정적으로 다루려면 카메라 영상과 언어 명령만으로는 부족합니다. 사람의 시연에서 접촉력과 촉각 같은 물리 정보를 수집해 학습하고, 행동하기 전에 월드 파운데이션 모델과 디지털 트윈으로 미래 결과를 예측해야 합니다. 이를 통해 로봇은 물리 세계를 단순히 보는 수준을 넘어 이해하고 판단할 수 있습니다.
이번 2편에서는 그 다음 흐름으로, 로봇이 물리 세계를 어떻게 배우고 예측할 수 있는지 살펴보려고 합니다.
먼저 Feel the Force와 OSMO를 통해 사람의 시연 데이에서 접촉력과 촉각 같은
물리량을 함께 수집하려는 연구들을 정리하고,
이어서 Cosmos WFM, Prompting with the Future, PhysWorld를 통해
World Foundation Model과 Digital Twin이
로봇의 행동 결과를 어떻게 미리 예측하려는지 파헤쳐보았습니다.
결국 Physical AI가 실제 세계에서 더 안정적으로 작동하려면,
로봇은 눈으로 보는 것을 넘어 물체와의 접촉, 힘의 변화, 그리고
행동 이후의 미래까지 함께 이해할 수 있어야 합니다.
이번 영상에서는 이러한 흐름이 최신 연구들에서 어떻게 나타나고 있는지 살펴보았습니다.
00:00 인트로
00:34 시연 데이에서 물리량을 함께 수집한다 | Feel the Force·OSMO
06:40 WFM/Digital Twin으로 물리 미래를 예측한다 | Cosmos·Prompting with the Future·PhysWorld
25:25 아웃트로
요약: 시각·언어·행동 모델은 사람의 명령과 카메라 영상을 바탕으로 로봇의 행동을 생성하지만, 실제 물체를 다루는 작업에서는 힘을 얼마나 주어야 하는지가 매우 중요합니다. ‘필 더 포스’와 ‘오스모’ 연구는 사람의 시연 데이터에서 영상뿐 아니라 접촉력과 촉각 같은 물리량을 수집하고 로봇 학습에 활용하는 방법을 제시합니다. 컵을 잡거나 서랍을 열고, 부드러운 물체를 다룰 때 필요한 정밀한 힘 조절 능력을 인간의 행동으로부터 전달하려는 것입니다.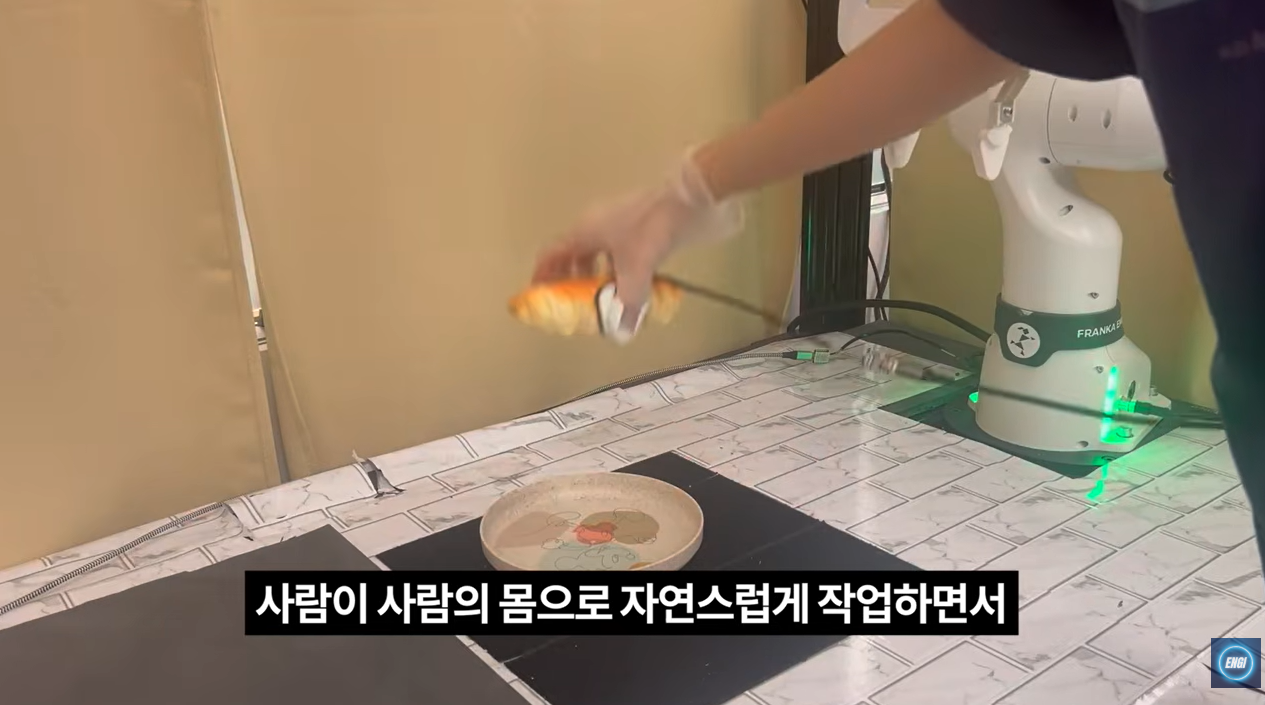
후반부에서 소개되는 코스모스, 미래를 활용한 프롬프팅, 피즈월드 연구는 로봇이 행동하기 전에 그 결과를 예측하는 기술에 초점을 맞춥니다. 월드 파운데이션 모델과 디지털 트윈을 이용하면 로봇이 물체를 밀거나 잡았을 때 어떤 변화가 일어날지를 가상 환경에서 먼저 확인할 수 있습니다. 앞으로의 로봇은 보이는 장면에 즉시 반응하는 수준을 넘어, 접촉과 힘을 이해하고 여러 행동의 미래 결과를 비교한 뒤 가장 안전하고 성공 가능성이 높은 행동을 선택하는 방향으로 발전할 전망입니다.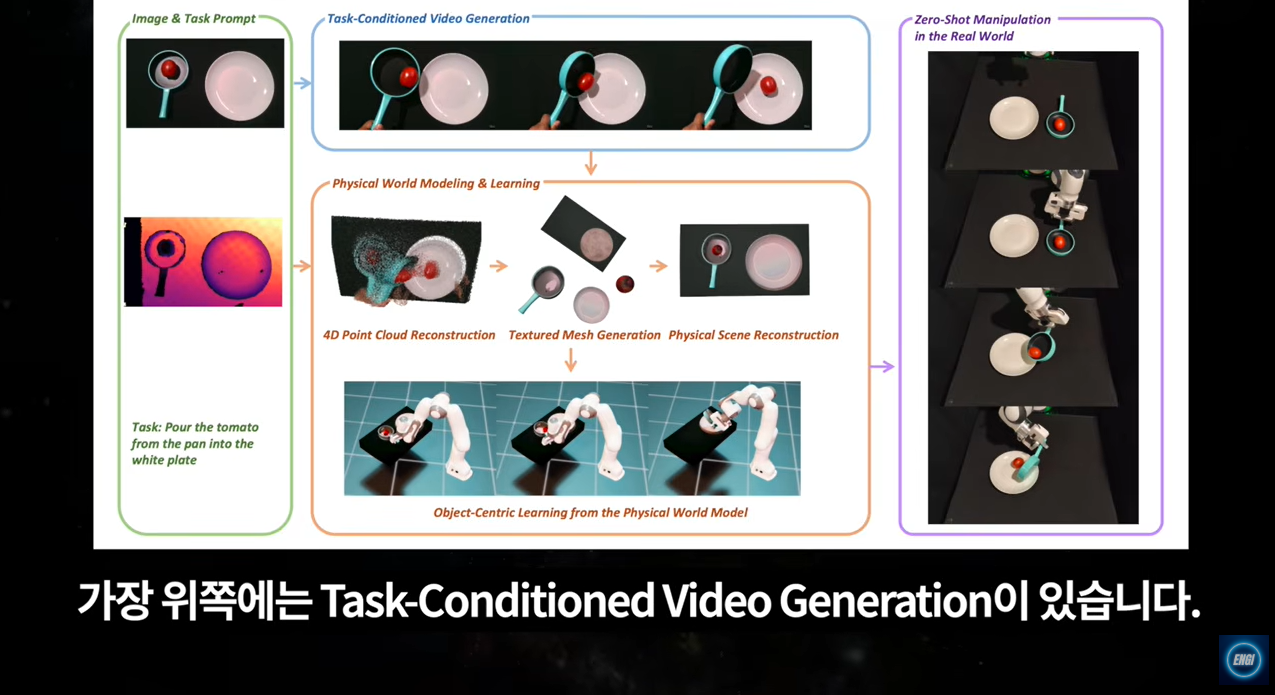
해시태그: #시각언어행동모델 #월드파운데이션모델 #디지털트윈 #피지컬AI #로보타운